
'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M14.504 8.522L12.746 4.49C12.6826 4.34486 12.5783 4.22136 12.4458 4.13463C12.3133 4.0479 12.1584 4.0017 12 4.0017C11.8416 4.0017 11.6867 4.0479 11.5542 4.13463C11.4217 4.22136 11.3174 4.34486 11.254 4.49L9.495 8.522C9.305 8.958 8.958 9.306 8.522 9.495L4.49 11.254C4.34486 11.3174 4.22136 11.4217 4.13463 11.5542C4.0479 11.6867 4.0017 11.8416 4.0017 12C4.0017 12.1584 4.0479 12.3133 4.13463 12.4458C4.22136 12.5783 4.34486 12.6826 4.49 12.746L8.523 14.504C8.959 14.694 9.307 15.042 9.496 15.478L11.255 19.511C11.3184 19.6561 11.4227 19.7796 11.5552 19.8664C11.6877 19.9531 11.8426 19.9993 12.001 19.9993C12.1594 19.9993 12.3143 19.9531 12.4468 19.8664C12.5793 19.7796 12.6836 19.6561 12.747 19.511L14.505 15.478C14.695 15.042 15.043 14.694 15.479 14.504L19.512 12.746C19.6571 12.6826 19.7806 12.5783 19.8674 12.4458C19.9541 12.3133 20.0003 12.1584 20.0003 12C20.0003 11.8416 19.9541 11.6867 19.8674 11.5542C19.7806 11.4217 19.6571 11.3174 19.512 11.254L15.479 9.495C15.043 9.30549 14.695 8.95782 14.505 8.522' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M3 3L5 5' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_4' d='M21 3L19 5' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_5' d='M3 21L5 19' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_6' d='M21 21L19 19' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_55'%3e %3crect width='24' height='24' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)
'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M14.375 7.66667H14.385' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M11.9792 20.125H5.75C4.9875 20.125 4.25624 19.8221 3.71707 19.2829C3.1779 18.7438 2.875 18.0125 2.875 17.25V5.75C2.875 4.9875 3.1779 4.25624 3.71707 3.71707C4.25624 3.1779 4.9875 2.875 5.75 2.875H17.25C18.0125 2.875 18.7438 3.1779 19.2829 3.71707C19.8221 4.25624 20.125 4.9875 20.125 5.75V11.9792' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_4' d='M2.875 15.3333L7.66667 10.5417C8.556 9.68587 9.65233 9.68587 10.5417 10.5417L14.375 14.375' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_5' d='M13.4167 13.4167L14.375 12.4583C15.0171 11.8412 15.7646 11.6687 16.4661 11.9408' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_6' d='M15.3333 18.2083H21.0833' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_7' d='M18.2083 15.3333V21.0833' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_4'%3e %3crect width='23' height='23' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)


'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M18.3333 10.5001V6.66667C18.3333 5.78261 17.9821 4.93477 17.357 4.30964C16.7319 3.68452 15.8841 3.33333 15 3.33333H5C4.11594 3.33333 3.2681 3.68452 2.64298 4.30964C2.01786 4.93477 1.66667 5.78261 1.66667 6.66667V13.3333C1.66667 14.2174 2.01786 15.0652 2.64298 15.6904C3.2681 16.3155 4.11594 16.6667 5 16.6667H11.6667M15.5 17.0001V12.0001M13 14.5001L15.5 12.0001L18 14.5001' stroke='var(--stroke-0%2c white)' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M8.33333 7.5L12.5 10L8.33333 12.5V7.5Z' stroke='var(--stroke-0%2c white)' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_4'%3e %3crect width='20' height='20' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)
'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M16.25 10.8333L21.1824 8.36767C21.3475 8.28515 21.531 8.2462 21.7154 8.25451C21.8998 8.26281 22.079 8.3181 22.2361 8.41512C22.3931 8.51214 22.5228 8.64768 22.6127 8.80888C22.7026 8.97007 22.7499 9.15158 22.75 9.33617V16.6638C22.7499 16.8484 22.7026 17.0299 22.6127 17.1911C22.5228 17.3523 22.3931 17.4879 22.2361 17.5849C22.079 17.6819 21.8998 17.7372 21.7154 17.7455C21.531 17.7538 21.3475 17.7148 21.1824 17.6323L16.25 15.1667V10.8333Z' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M3.25 8.66667C3.25 8.09203 3.47827 7.54093 3.8846 7.1346C4.29093 6.72827 4.84203 6.5 5.41667 6.5H14.0833C14.658 6.5 15.2091 6.72827 15.6154 7.1346C16.0217 7.54093 16.25 8.09203 16.25 8.66667V17.3333C16.25 17.908 16.0217 18.4591 15.6154 18.8654C15.2091 19.2717 14.658 19.5 14.0833 19.5H5.41667C4.84203 19.5 4.29093 19.2717 3.8846 18.8654C3.47827 18.4591 3.25 17.908 3.25 17.3333V8.66667Z' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_4' d='M7.58333 13H11.9167' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_5' d='M9.75 10.8333V15.1667' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_47'%3e %3crect width='26' height='26' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)
'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M4 7H7M11 7H20' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M4 17H20' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_4' d='M7 4L7 20' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_5' d='M17 4V13M17 17V20' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_60'%3e %3crect width='24' height='24' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)
'%3e %3cg id='Vector'%3e %3c/g%3e %3cpath id='Vector_2' d='M6 10L4 11L12 15L20 11L18 10' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_3' d='M4 15L12 19L20 15' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_4' d='M12 4V11' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3cpath id='Vector_5' d='M15 8L12 11L9 8' stroke='var(--stroke-0%2c white)' stroke-width='1.25' stroke-linecap='round' stroke-linejoin='round'/%3e %3c/g%3e %3cdefs%3e %3cclipPath id='clip0_0_9'%3e %3crect width='24' height='24' fill='white'/%3e %3c/clipPath%3e %3c/defs%3e %3c/svg%3e)


VLM视觉语言模型是什么?原理、区别与应用场景全解析
本文解析VLM视觉语言模型的定义、原理及与单模态模型的区别,结合RunningHub平台介绍其应用场景、操作步骤与实用案例,助力创作者快速掌握并落地多模态AI创作能力。
VLM视觉语言模型是什么?原理、区别与应用场景全解析
想搞懂 VLM(视觉语言模型)是什么?本文详解视觉语言大模型的工作原理、视觉模型和语言模型的区别、核心应用场景及代表模型,帮助你快速理解多模态 AI 模型能力。
很多人第一次听到 VLM(Vision Language Models,视觉语言模型),都会问同一个问题:它和普通的大语言模型到底有什么区别?简单说,传统大语言模型只"读文字",而视觉语言模型能同时"看图"和"读文字",并把两者结合起来理解和生成内容。
无论是给一张商品图写详细描述、回答图片里的问题,还是从一张设计图反推提示词,VLM 都在默默发挥作用。对做电商素材、短视频、AI 绘画或内容创作的人来说,搞清楚视觉语言模型是什么、怎么工作、视觉模型和语言模型的区别在哪里,能帮你更快选对 AI 模型工具、写出更准的提示词,也更容易理解现在很多 AI 平台的多模态能力。
下面我们用尽量直白的方式,把 VLM(视觉语言模型)讲清楚。
一、VLM(视觉语言模型)适合解决什么问题?
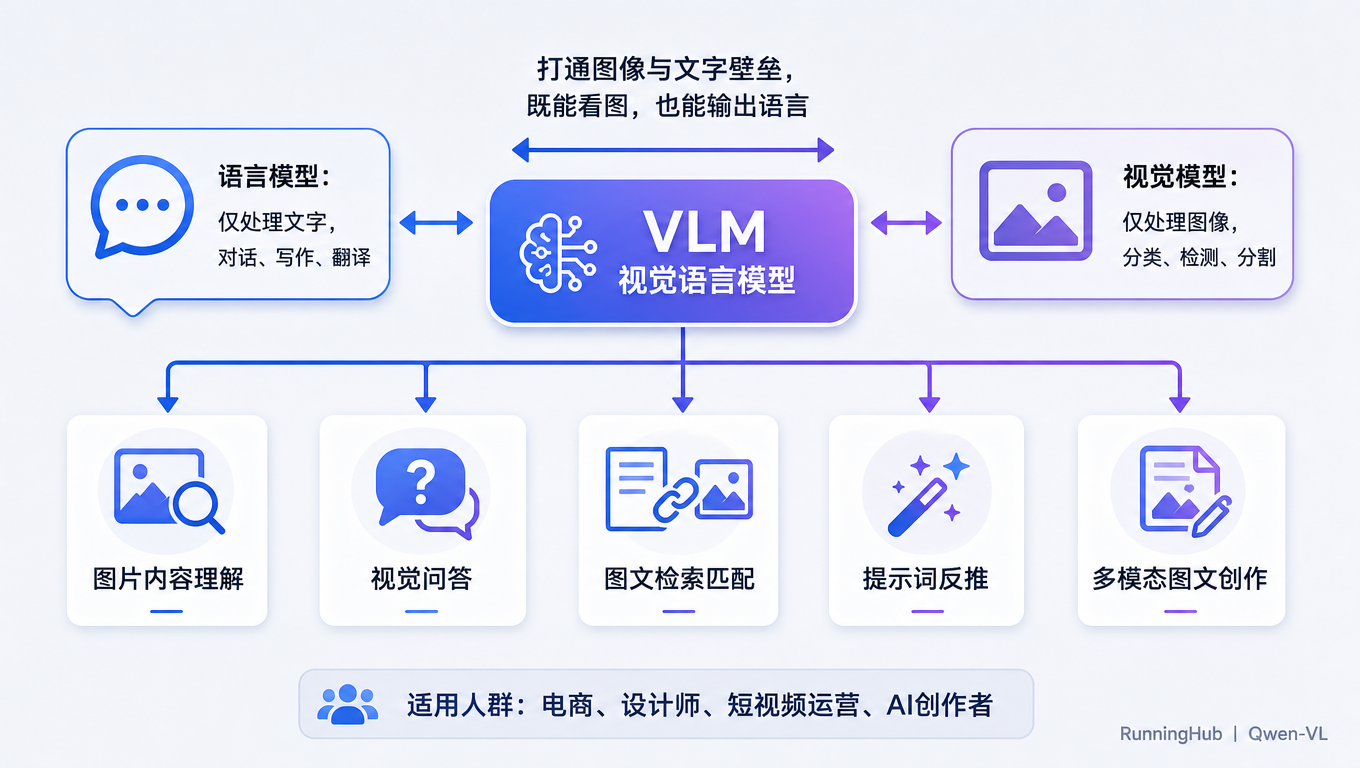
要理解视觉语言模型的价值,先搞清楚视觉模型和语言模型的区别。传统 AI 模型往往是"各管一摊":语言模型(如 GPT 系列)只处理文字输入和输出,擅长对话、写作和翻译;视觉模型(如 CNN、ViT)只处理图像,擅长分类、检测和分割。两者之间缺少直接对话能力——语言模型看不懂图,视觉模型说不出话。VLM 的出现,就是为了打通这个壁垒,让一个 AI 模型同时具备"看图"和"说话"的能力。
作为一种视觉语言大模型,VLM 主要解决以下几类实际问题:
- 图片内容理解:上传一张图,模型能描述画面、识别物体、判断风格,甚至读出图中的文字(OCR)。
- 视觉问答:针对图片提问,比如"这件衣服是什么颜色?""背景是室内还是室外?"
- 图文检索与匹配:用文字找图,或用图找相似描述。
- 提示词反推与内容生成辅助:看到一张效果图,想知道大概用了什么提示词,VLM 能帮忙分析。
- 多模态创作与编辑:结合图像和文字指令,完成更精准的生成或修改。
对电商卖家、设计师、短视频运营和 AI 创作者来说,这些能力直接对应日常痛点——不会写详细 Prompt、缺少素材描述、想快速理解参考图、需要批量分析商品图等。
在 RunningHub 这样的云端 ComfyUI 与 AI 创作平台上,很多工作流和 AI 应用已经接入了具备视觉理解能力的 AI 模型(例如基于 Qwen-VL 系列的反推提示词工作流),用户可以直接调用相关能力,而不必自己部署复杂的视觉语言大模型环境。
二、为什么建议通过 RunningHub 使用 VLM 相关能力?
视觉语言模型不是单纯的"技术名词",它正在改变 AI 创作的工作方式。过去做图生图或图生视频,主要靠人工写提示词或简单标签;现在,很多工具会先用 VLM 理解参考图,再生成更精准的描述或控制信号,效果更稳定。对普通用户来说,这意味着:
- 不需要完全靠自己写很长的 Prompt,模型能先"看懂"图片。
- 可以更方便地做风格迁移、商品一致性控制、细节修改。
- 在云端平台使用时,门槛更低,不用本地部署大模型。
要理解视觉语言大模型的能力边界,可以把它拆成三个组成部分:视觉编码器负责把图片切成小块、提取视觉特征;投影/对齐模块把视觉特征映射到语言模型能理解的向量空间,让"图像信息"和"文字信息"处于同一维度;语言模型则接收对齐后的视觉特征与文字指令,输出最终回答或描述。理解这套结构,能帮你更快判断 VLM 在什么时候好用、什么时候需要换方案。
目前 VLM 已经形成两类主要 AI 模型选择:一类是 GPT-4V / GPT-4o(OpenAI)、Gemini 系列(Google)、Claude 3 系列(Anthropic)等闭源商业模型,综合能力强;另一类是 LLaVA、Qwen-VL、InternVL 等开源视觉语言模型,中文与文档理解表现优秀,很多国内工作流都会用到。
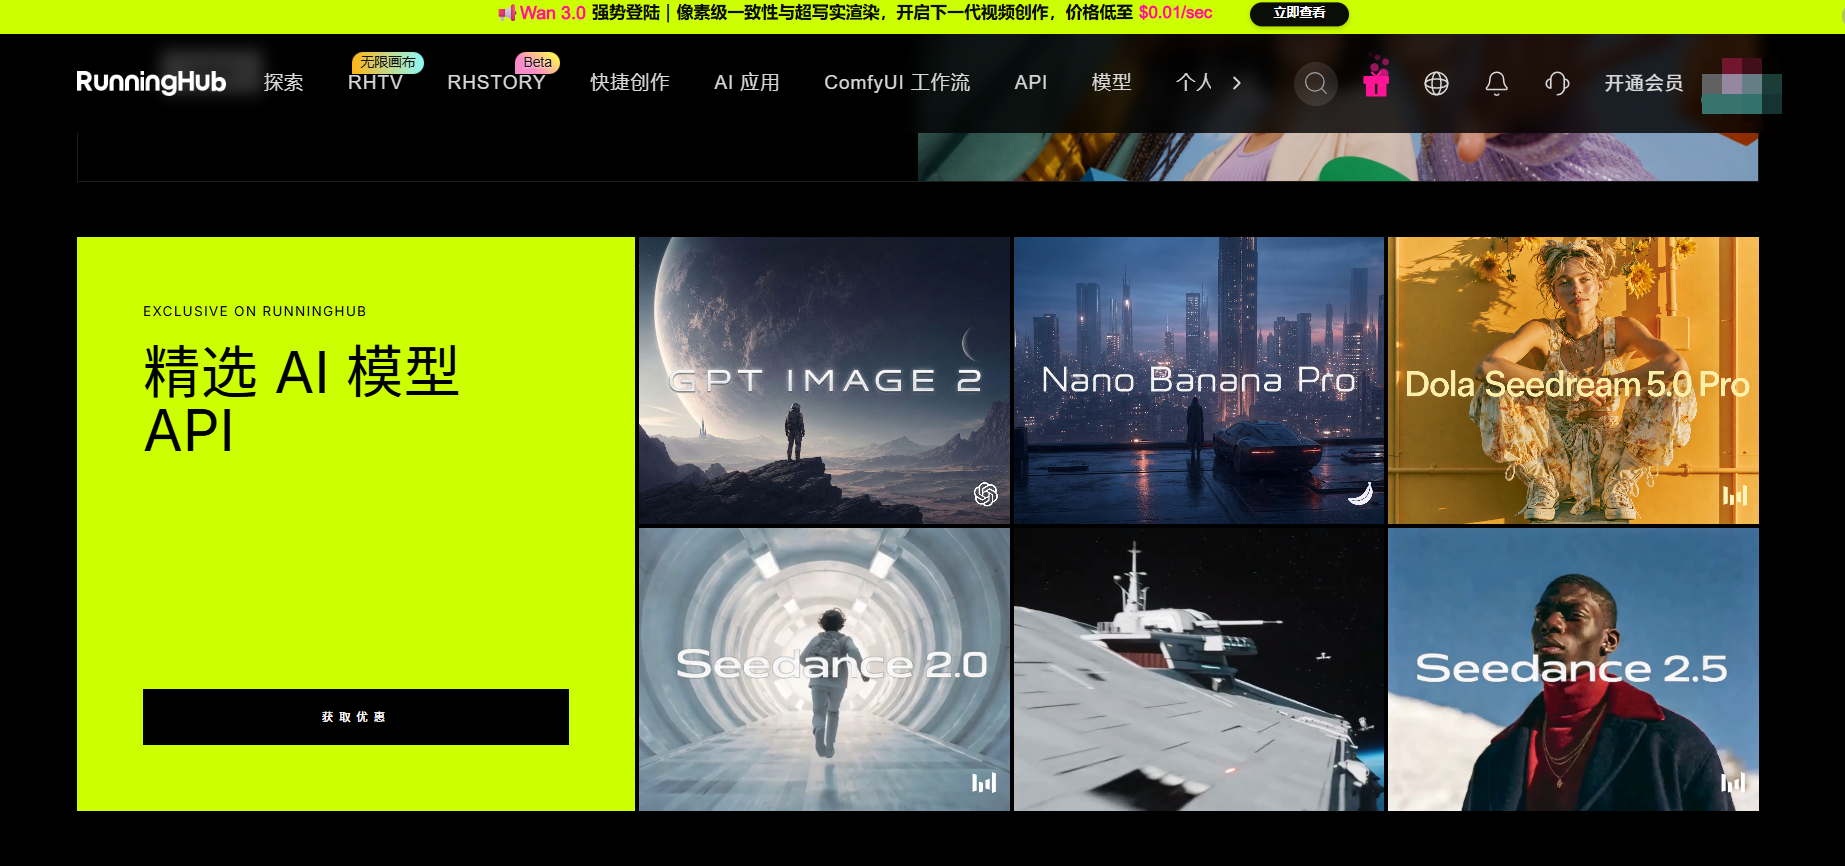
RunningHub 作为面向创作者的云端 ComfyUI 与模型 API 平台,已经集成了多模态相关能力。用户可以在工作流中调用具备图像理解功能的 AI 模型,或直接使用社区分享的 VLM 相关工作流(例如基于 Qwen-VL 的提示词反推),快速完成从"看图"到"生成"的完整链路,无需自己下载和部署视觉语言大模型。
三、如何使用 VLM 完成任务?
无需本地下载、部署视觉大模型,在 RunningHub 平台直接调用社区预制的工作流或封装好的 AI 应用,即可完成看图理解、图文解析任务。整套操作分为 4 个步骤。
Step 1:进入 RunningHub,根据任务搜索 VLM 工作流
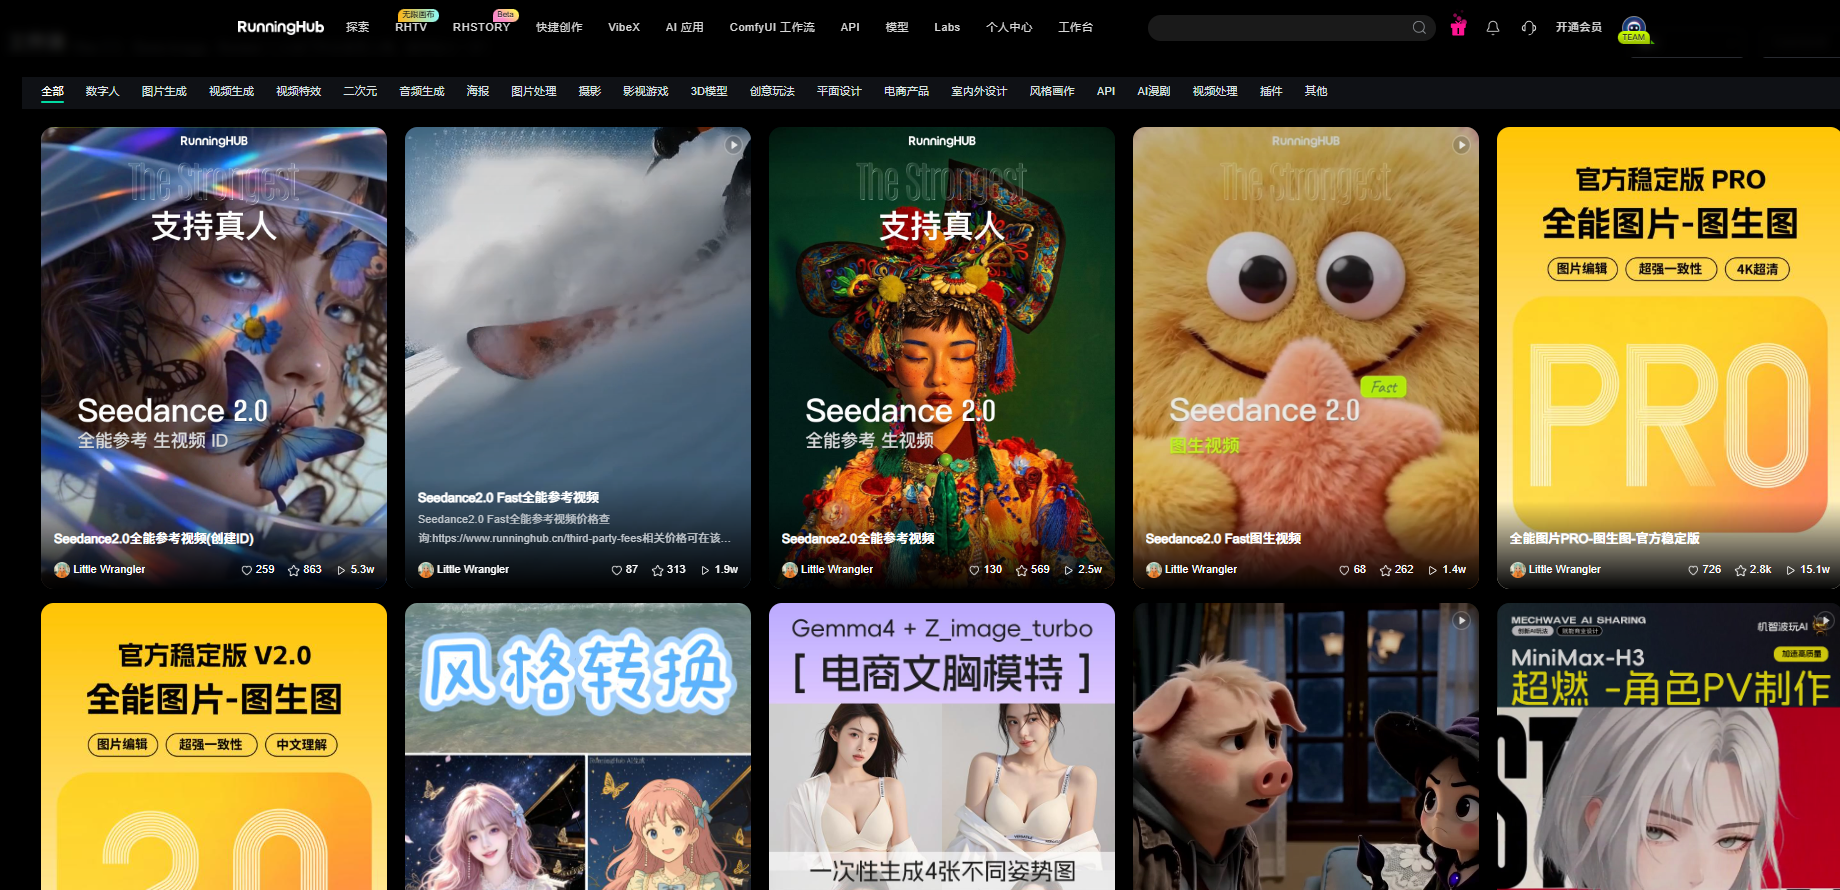
进入 RunningHub 后,首先根据自己的需求寻找合适的工作流。
如果只是想让 AI 分析图片,可以搜索 VLM、Qwen-VL、Qwen2-VL、Qwen3-VL、图片理解、图片描述等关键词;如果希望进一步完成提示词反推、图片生成等任务,则可以直接搜索对应的工作流类型。
与从零搭建 ComfyUI 工作流相比,直接使用社区已经配置好的工作流,可以省去模型下载、节点连接和参数配置等准备工作。找到合适的工作流后,可以先查看其输入、输出和使用说明,再决定是否直接运行。
Step 2:选择工作流并上传参考图片
找到合适的工作流后,进入工作流页面。
以“图片理解 / Prompt 反推”这类任务为例,通常需要先上传一张参考图片,再由 VLM 对图片中的主体、场景、构图、光线等信息进行分析。
这里的输入图片质量会直接影响最终结果。
例如,如果想让 VLM 分析一张人物摄影图,可以上传:
如果想分析商品,则更适合上传:
- 商品白底图;
- 电商主图;
- 商品场景图;
- 模特穿搭图。
如果想进行 OCR 或海报解析,则可以上传:
- 活动海报;
- 网页截图;
- PPT 截图;
- 产品说明书;
- 包含文字的信息图。
简单来说,上传什么图片,取决于你希望 VLM 最终回答什么问题。
例如:如果你想提取海报文案,优先上传文字清晰的原图;如果你想复刻画面风格,优先上传构图完整、光影保留完整的参考图。
Step 3:输入具体指令,让 VLM 按要求分析图片
上传图片后,不建议只输入“分析这张图”,而是明确告诉模型分析什么、输出什么。
例如,如果只是想知道图片中有什么,可以输入:详细描述这张图片里包含哪些物体、人物、场景,描述画面的整体氛围。
如果是为了生成 AI 绘图 Prompt,则可以进一步要求:析图片的构图、光影、色彩、艺术风格、镜头参数,输出一段适合文生图模型使用的英文正向提示词。
如果是商品图分析,则可以要求:识别这件商品,描述外观、颜色、材质,提炼适合电商详情页的卖点,输出结构化文字。
指令越明确,最终结果越容易直接用于后续的图片生成、视频生成或内容创作。
Step 4:运行工作流并获取结果
点击运行后,VLM 会根据图片和指令生成对应结果。输出可以是图片描述、标签、OCR文字、Prompt、JSON结构化数据等,也可以继续连接图像生成节点,形成“图片理解→Prompt生成→图片生成”的自动化流程。
例如,RunningHub 社区中的 Qwen2-VL 图像分析工作流,可以自动识别输入图片内容,并生成用于后续图生图的 Prompt,再进行图片重绘。
四、VLM 应用案例与 Prompt 示例
下面给出 3 组可直接套用的案例,覆盖电商、绘画和设计运营三类常见场景。
案例示例 1:商品图自动描述 适合用户:电商运营 适合场景:批量生成商品标题和卖点 推荐方式:图生文 可复制 Prompt 示例:"请详细描述这张商品图,包括主体物品、颜色、材质、风格、使用场景,并提炼 3 个核心卖点,语言简洁专业。" 使用建议:先让视觉语言模型输出完整描述,再人工微调成最终文案。可替换商品图和需要强调的卖点方向。
案例示例 2:参考图反推提示词 适合用户:AI 绘画创作者 适合场景:看到喜欢的图,想复现或魔改 推荐方式:图生文 可复制 Prompt 示例: "请分析这张图片的构图、光影、风格、主体特征,生成一段适合文生图的详细提示词,包含画质和镜头描述。"使用建议:反推得到的提示词可作为文生图或图生图的基础,再按需调整风格词和负面词。
案例示例 3:视觉问答 适合用户:设计师 / 运营 适合场景:快速确认图片细节 推荐方式:图生文 可复制 Prompt 示例: "图中主体人物穿的是什么颜色的衣服?背景是什么场景?整体风格偏写实还是插画?" 使用建议:把问题拆成可确认的具体项,视觉语言模型的回答会更准确;需要时可继续多轮追问细节。
五、常见问题 FAQ
Q1:VLM(视觉语言模型)适合新手吗? 适合。现在很多平台已经把视觉语言模型能力封装成工作流或应用,用户只需上传图片和输入简单问题,就能直接使用,不需要自己部署 AI 模型。
Q2:视觉模型和语言模型有什么区别? 视觉模型只处理图像,擅长分类、检测、分割等任务,但无法生成文字描述;语言模型只处理文字,擅长对话、写作、翻译,但看不懂图片内容。VLM(视觉语言模型)则把两者结合,能同时理解图像和文字,并根据图片生成文字回答或描述。简单说,视觉模型是"看图的",语言模型是"说话的",VLM 是"既能看图又能说话的"。
Q3:使用 VLM 需要准备什么素材? 主要是清晰的图片。如果是文档理解,尽量提供高清扫描件或截图;如果是商品图,主体尽量完整、光线充足。
Q4:Prompt 应该怎么写效果更好? 尽量明确任务、细节要求和输出格式。例如:"请用中文详细描述这张图,重点说明主体、颜色、风格,并生成适合文生图的提示词。"
Q5:生成效果不好怎么办? 可以换更清晰的图片、把问题写得更具体,或者换一个在中文/文档方面更强的视觉语言大模型。多轮追问也能有效提升结果。
Q6:可以用于商业发布吗? AI 模型本身输出的文字描述一般可作为参考,但最终商用内容需遵守对应平台和模型的使用规则。具体以 RunningHub 平台规则及所调用视觉语言模型的官方说明为准。
六、总结与 CTA
VLM(视觉语言模型)让 AI 真正具备了"看图说话"的能力,把图像理解和语言生成连成一体。无论是自动写商品描述、反推提示词,还是做视觉问答,它都能显著提升创作效率。理解视觉模型和语言模型的区别,也能帮你在面对不同任务时选对合适的 AI 模型。
对创作者来说,最实用的做法不是死记硬背模型参数,而是在真实场景中多试:上传自己的图片,提出具体问题,观察不同视觉语言大模型的输出差异。RunningHub 提供了云端 ComfyUI 工作流和相关 AI 应用,用户可以直接调用具备视觉理解能力的 AI 模型,快速完成从理解到生成的完整流程。